Многие программисты на первом курсе пишут игру «Жизнь» Конвея: поле из клеток, несколкьо правил про соседей, и на экране сами собой заводятся глайдеры, мигалки и всякие устойчивые фигуры. Меня когда-то зацепило в ней не то, что это красиво, а то, что осмысленное поведение вырастает из правил, которых для этого поведения никто отдельно не писал. Три условия про живые и мёртвые клетки, а на экране будто что-то ползает и живёт своей жизнью.
Мне захотелось потрогать эту самоорганизацию не на клетках, а на чём-то более сложном. Мир где живут животные со своим поведением, чтобы они ели, пили, размножались, охотились друг на друга и при этом как-то уживались: не вымирали все разом и не заполоняли всё поле одним видом. Простая идея, я возвращался к ней лет десять по паре вечеров в год, когда руки доходили. И почти всё это время ничего толком не получалось.
Ниже я разберу, почему не получалось и что в итоге сработало. Если коротко, я перестал прописывать поведение животных руками и начал его обучать.
Почему в лоб не вышло
Первые заходы я делал очевидным для программиста способом: нужно, чтобы олень искал еду, я так и пишу. Видит траву, идёт к траве. Видит волка, убегает. Хочет пить, идёт к воде. Каждое поведение отдельным условием, и по мере того как я добавлял виды и ситуации, условий становилось всё больше.
Пока зверь один в пустом поле, такой подход работает. Проблемы начинаются, когда зверей сотни и когда у мира появляется своя экономика ресурсов. Трава отрастает с какой-то скоростью, олень её ест с какой-то, начинает плодиться при каком-то запасе энергии, волк догоняет оленя с какой-то. Все эти парамтеры связаны между собой, и стоит тронуть одно, разъезжается остальное. Прибавишь растениям плодовитости, олени размножаются и выедают её подчистую, а потом вымирают от голода сами. Ослабишь волков, олени заполоняют карту. Усилишь, волки за пару дней съедают всех и остаются в пустом мире.
Этих настроек у меня было под сотню, и я крутил их вручную. Поправишь одну, ломается равновесие, которое ты только что с трудом собрал через другую. Мир жил минут десять и сваливался в одну из крайностей: все передохли от голода, либо остался один вид, съевший всех. Тоже потом дохнет, есть то нечего =) Устойчивого состояния, когда виды просто сосуществуют и ни один не выигрывает окончательно, я так и не добился.
Отдельно раздражало, что и само поведение по правилам выходило слишком ветвистым. У живого зверя решения зависят сразу от многих вещей, и в набор if-ов это укладывается плохо. Олень пасётся, но должен поглядывать по сторонам. Убегает, но желательно не в сторону второго волка. Держится стада, но не толпится вплотную у воды. Код разрастался, а звери от этого почему-то умнее не становились.
В какой-то момент я понял, что зашёл не с той стороны. Я пытался словами описать разумное поведение, хотя по-хорошему его надо было получить так же, как в «Жизни» получаются глайдеры: не задавать напрямую, а создать условия, при которых оно возникает само (эмерджентность).
Идея: не описывать поведение, а обучать ему
Замысел, к которому я в итоге пришёл, такой. У каждого животного стоит небольшая нейросеть, его «мозг» — совсем простой многослойный перцептрон. На вход она получает то, что зверь видит и чувствует, на выходе выдаёт решение: куда идти, есть ли, убегать ли. Правила поведения я не пишу (точнее пишу, но об этом позже). Я устраиваю отбор: кто ведёт себя удачнее, тот выживает и оставляет потомство, и его вариант поведения закрепляется.
По сути это эволюция, только внутри симуляции и быстрее, чем в природе. Гены животного тут заменяют веса нейросети, а критерий отбора тот же, что и в жизни: сумел прокормиться и оставить потомство или нет.
С этим замыслом вылезает проблема. Если посадить в мир сеть со случайными весами и включить отбор генетическим алгоритмом (GA), ничего не произойдёт. Случайный мозг не делает ничего осмысленного, зверь почти сразу гибнет, следующий тоже, и так вся популяция. Все особи одинаково беспомощны, и отбору не из чего выбирать: между «плохо» и «плохо» разницы нет. Эволюция топчется на месте и перебирает шум поколение за поколением. Та же беда, кстати, и у обучения с подкреплением (RL), если запускать его с нуля: награда приходит слишком редко, чтобы понять, какой именно шаг был правильным (это называют проблемой доверия, credit assignment).
В природе это вытягивают миллиарды особей и миллионы лет. У меня столько времени нет, поэтому нужно было начинать не с нуля, способ поднять популяцию до минимально осмысленного уровня, с которого отбору уже есть что улучшать. И толчком послужил как раз тот код на правилах, который до этого меня подводил.
Болванчик: учитель на правилах
Я собрал из своих старых if-ов отдельного персонажа. В проекте я зову его болванчиком. Это простой алгоритм: видит стену, сворачивает, видит еду, идёт к ней, видит хищника, убегает. Умнее он не станет, зато ведёт себя осмысленно с первого же шага и работает стабильно.
Дальше болванчик работает учителем. Он живёт в мире и на каждом шаге принимает решение, глядя на свои датчики - сенсоры, а я записываю пары «что он видел и что после этого сделал». Таких пар сотни тысяч. Потом градиентным спуском я подкручиваю веса нейросети, пока она на тех же входах не начинает выдавать примерно те же решения. В машинном обучении это называют клонированием поведения (behavior cloning), частный случай обучения с учителем: сеть подгоняют повторять правильные ответы, как школьника прогоняют по решённым задачам.
Так болванчик из источника проблем превращается в стартовую площадку. Сам по себе он никакое не решение, но он вытягивает сеть из случайного хаоса на уровень «умеет ходить, есть и убегать». Всё интересное начинается уже после него, когда за дело берётся отбор.
Одно ограничение я держу с самого начала: и болванчик, и нейросеть видят только свои датчики. Никакого взгляда на карту сверху и рентгена всей карты поиском в ширину, никаких абсолютных координат, только то, что зверь реально может почувствовать вокруг себя: что перед ним, далеко ли вода, есть ли рядом волк, сколько осталось сил. Иначе учитель решал бы, зная то, чего ученик не видит, и повторить его ходы ученик бы физически не смог. И вообще не спортивно это, в реальном мире животные полагаются только на то что непосредственно видят/чувствуют. Идем тем же путем.
Экзамен для учителя
Довольно быстро выяснилось, что нейросеть выходит ровно такой же, как примеры болванчика. Если тот где-то ошибается, заводит оленя в тупик или застревает у камня, сеть послушно перенимает и эту ошибку. Значит, учитель должен быть аккуратным, и его нужно проверять.
Для проверки я сделал набор небольших арен, я называю их стендами. На каждой одна понятная задача: обойти камень и дойти до травы, выбраться из кармана между скал, заметить хищника и убежать, найти воду за препятствием. Чтобы сеть не заучивала конкретную расстановку, каждый стенд размножается на сотни вариаций со сдвинутым камнем, другой стартовой точкой, зеркальным отражением, поворотом.
Стенды можно погонять вживую — видно, как болванчик и нейросеть проходят одни и те же арены. А в редакторе можно собрать свой стенд: расставить камни, воду, еду, хищника и посмотреть, справятся ли они.
Требование к болванчику простое: он должен проходить все вариации, а не большинство. Он единственный источник правильных ответов, и учить сеть на его провалах бессмысленно. Довести старый алгоритм до прохождения всех стендов на всех вариациях оказалось той еще задачей, но без неё двигаться дальше нет смысла.
Т.е. буквально дописываем if'ы к его коду, если он с чем-то не справляется.
Слабое место обучения по примерам
У клонирования поведения есть неприятная особенность, на которую я налетел не сразу. Болванчик в своих примерах проходит стенд чисто и с маршрута не сходит, поэтому он никогда не показывает, что делать, если ты уже ошибся и оказался не там.
Аналогия тут простая. Представь, что учишься водить, наблюдая за идеальным водителем, который всегда держится центра полосы. Он ни разу не покажет, как возвращаться с обочины, потому что сам туда не съезжает. И когда ты сам чуть уходишь в сторону, ты оказываешься в ситуации, которой не видел ни разу, дальше ошибаешься сильнее, и всё ломается.
С сетью происходит ровно это: она немного промахивается, попадает в положение, которого в примерах болванчика не было, там теряется совсем. Ошибки накапливаются одна на другую, у этой беды есть имя, сдвиг распределения (distribution shift): сеть работает уже не в тех ситуациях, на которых её учили.
Полечилось довольно изящно, приёмом под названием DAgger (Dataset Aggregation). Я даю управлять самой сети, и она заходит в свои собственные кривые ситуации, куда идеальный учитель не забредает. А потом из этой точки передаю управление болванчику и записываю, как он оттуда выбирается. Эти примеры возврата на маршрут я добавляю в обучение. Теперь, если сеть заносит в сторону, она сама выбирается обратно, а не теряется окончательно. Такой догфудинг на собственных ошибках.
Здесь важно, что я не пытаюсь определить, когда сеть «повела себя неправильно», детектора тут нет. Я просто отдаю ей руль на часть пути, а потом передаю болванчику независимо от того, хорошо она ехала или плохо. Плохие ситуации я не отлавливаю, а специально создаю, чтобы снять с болванчика правильный выход из них. Чем дольше сеть уже обучена, тем позже я перехватываю управление, так что сначала правятся ранние срывы, а потом всё более поздние.
Все эти примеры также идут в копилку обучения с учителем.
Что у оленя в голове
Сам мозг устроен скромнее, чем можно ожидать. На вход идут 59 нормализованных чисел: направления и расстояния до еды, воды, хищника и соседей, собственные голод, жажда, усталость и возраст, а ещё короткие лучи-«усы» вокруг тела, по которым видно, упрёшься ли ты в стену, если пойдёшь в ту сторону. Плюс несколько ячеек памяти (упрощённый управляемый рекуррентный блок, GRU-lite), чтобы зверь не был совсем беспамятным от шага к шагу. Это точно такие же сенсоры. В прошлый раз повернули и там был тупик, помним что мы повернули слева.
У болванчика такой же набор входных данных.
А это уже устройство самой сети, что в неё входит и что из неё выходит.
Устройство мозга: сенсоры и память → скрытый слой (64 на курс, 32 на действия) → указатели курса и 5 действий, с возвратом памяти на следующий шаг.
Дальше один слой из 96 нейронов, а на выходе решение: куда повернуть, с какой скоростью идти, есть ли, пить, искать ли пару, спать. Сеть не выдаёт угол поворота напрямую, а выбирает цель из набора осмысленных направлений (к еде, к воде, прочь от волка) и берёт лучшую по оценке (arg max). Так оказалось надёжнее, если усреднять два направления в одно, легко получить третье, никуда не ведущее, ровно в лоб камню, который обе исходные дороги аккуратно обходили.
Почему сеть выбирает одно направление, а не усредняет два: среднее двух хороших путей ведёт прямо в камень.
Почему сеть такая мелкая? Всего один слой, и почему этого хватает при том, что поведение у болванчика вроде бы сложное: если стена, поверни, пройди, если снова стена, развернись, целая цепочка условий. Дело в том, что эта цепочка разворачивается во времени, а не внутри одного прохода сети. Зверь на каждом шаге смотрит на текущие датчики и делает ровно один ход, а «пройди, потом проверь снова» это уже следующий шаг. Роль цикла играет сам мир, и сети не нужно держать всю процедуру в голове целиком, ей достаточно сопоставить то, что видно сейчас, тому, что делать сейчас. Отдельное условие вроде «впереди стена» это просто порог по одному датчику, то есть один нейрон, и таких нейронов кладут рядом, а не друг на друга. Тут выручают сенсоры памяти: они не дают ходить по кругу.
Дополнительные слои понадобились бы для другого, например чтобы строить сложные образы из сырой картинки или просчитывать несколько ходов вперёд, но пока задача до этого не доросла, хватает ширины и небольшой памяти. Не усложнять без нужды — бритва Оккама.
Отбор уводит сеть от учителя
После обучения по примерам и работы над ошибками сеть проходит почти все стенды, но это всё ещё только копия болванчика: она умеет то же, что он, и не больше. Дальше подключается то, ради чего всё и затевалось.
Я беру не одну сеть, а популяцию с мелкими случайными отличиями, прогоняю через испытания, оставляю тех, кто справился лучше (функция приспособленности), скрещиваю их веса и добавляю мутации, и так поколение за поколением. Это генетический алгоритм поверх весов сети, то есть нейроэволюция. Разница с обучением по примерам принципиальная: там сеть награждалась за похожесть на учителя, а здесь за результат, то есть за то, что зверь выжил, поел, оставил потомство. Цели разные, поэтому сеть постепенно отходит от того, как поступил бы болванчик, к тому, что реально работает.
С этим этапом связан урок, который дался мне не сразу. Если слишком усердно гонять сеть по стендам, она становится отличницей на стендах и беспомощной в реальном мире: попросту заучивает арены (переобучение). Чтобы это ловить, часть вариаций я прячу и проверяю сеть на тех раскладках, которых она не видела (held-out, отложенная выборка). Но и этого мало: итоговый мозг я выбираю не по оценке за стенды, а по тому, как он ведёт себя в большом мире, не топчется ли на месте, не сбивается ли в кучу, добывает ли еду. Хорошая отметка за стенд сама по себе ничего не гарантирует.
Большой мир и наследование мозга
Настоящая проверка это уже не арена с одним камнем, а большой мир: сотни зверей, восемь видов, теснота у водопоя, конкуренция за пастбище, хищники между деревьями.
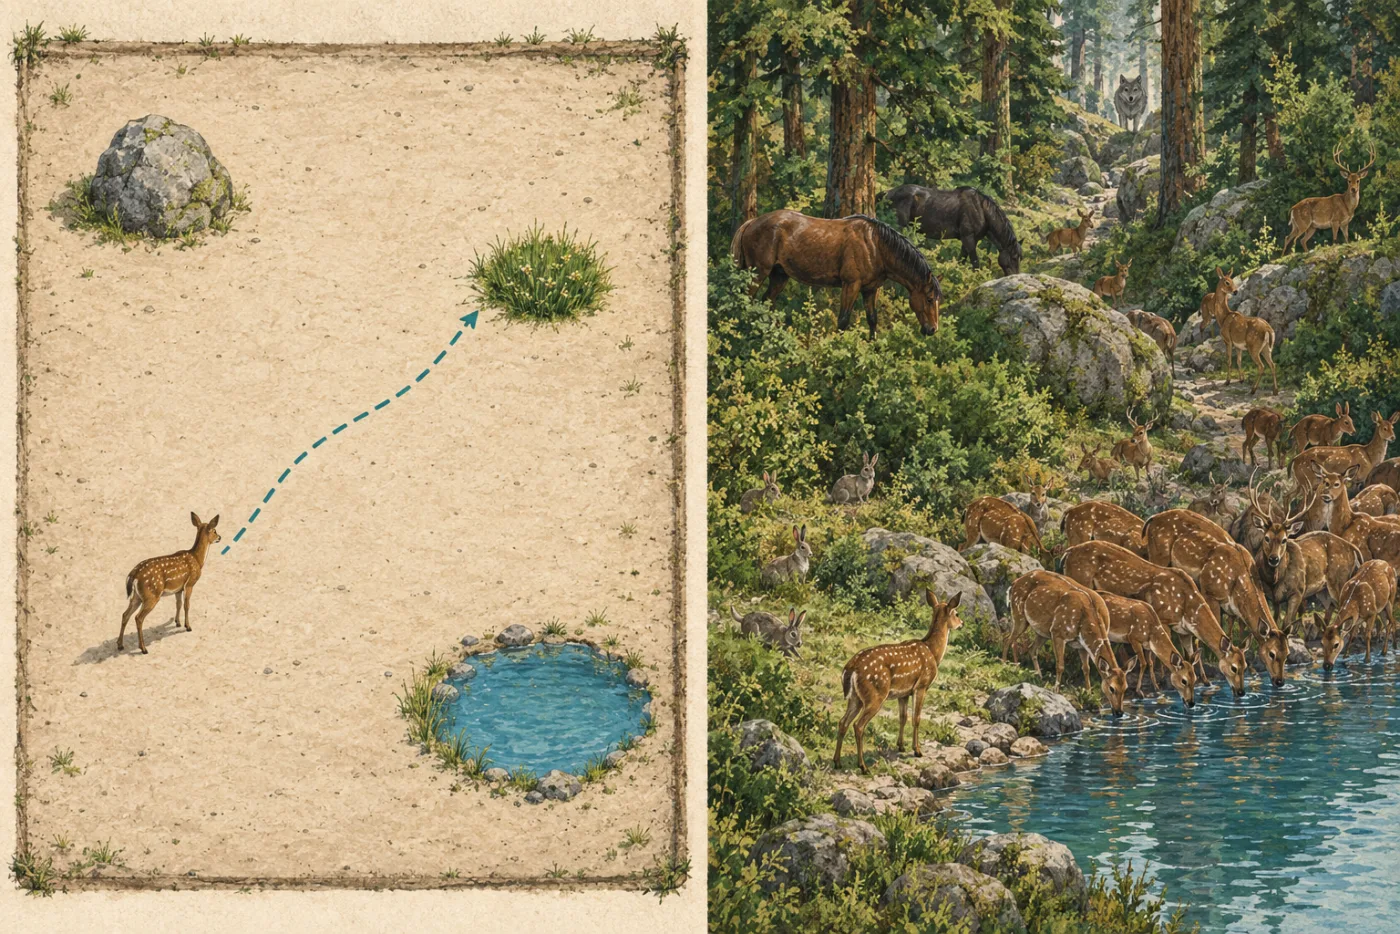
Здесь эволюция встает во всей красе, и реально происходит на экране. У каждого зверя свой отдельный мозг, а не общий на всех. Когда двое приносят потомство, детёныш получает смесь родительских мозгов и небольшую мутацию, ровно как гены. Отдельной функции награды тут уже нет, её роль играет сам мир, это буквально естественный отбор: кто лучше кормится, вовремя убегает и успевает завести потомство, у того веса и расходятся по популяции, а кто не справился, тот свой вариант мозга и не передаёт. Болванчик дал старт, отбор на стендах довёл мозг до вменяемости, а дальше он меняется сам под давлением обычной жизни в мире.
Что ломалось по дороге
Не хочу оставлять впечатление, что всё это работает и работало гладко. Многое попортило мне кровь, об этом обычно не пишут.
Дольше всего я провозился с животными, которые просто стояли на месте. На стендах сеть проходит всё уверенно, а в большом мире целые группы зверей замирают и гибнут от голода прямо посреди травы. Я грешил на баланс, пока не понял, что дело в движении: без явной цели сеть выдавала дёрганый курс, шаг влево, шаг вправо, и зверь топтался на месте до смерти. У болванчика такого не было, потому что он двигался с помощью приёмов, которые в чистую сеть не переносятся - задал курс, двигаемся не думая. Пришлось часть этих приёмов вернуть отдельно, в код, как врождённые рефлексы (субсумпционная архитектура — рефлексы снизу, мышление сверху): расталкиваться в толпе, держать выбранный курс, пока идёшь искать корм. Это не решения мозга, а что-то вроде инстинктов, которым животное не учится, они у него есть по умолчанию.
Похожая история вышла со страхом. Когда я перевёл травоядных на нейросеть, они стали спокойно пастись рядом с волками, и со стороны это выглядело так, будто они перестали бояться. На деле бояться они не перестали, а замечали хищника слишком поздно, когда тот уже вплотную и бежать некуда. У болванчика было чутьё на большем расстоянии, а у сети нет, и стоило вернуть это дальнее чутьё, стадо снова стало разбегаться заранее.
И, конечно, тот самый баланс, из-за которого всё начиналось. Даже с обученными зверями восемь видов не желали уживаться сами по себе: то травоядные устраивали демографический взрыв, то хищники выедали редкие виды до нуля. Я разбирался с этим долго и по частям, где-то убавляя плодовитость, где-то добавляя хищникам выносливости, где-то перестраивая, как в мире отрастают растения. Сейчас мир держится: все восемь видов сосуществуют десятки тысяч шагов, и ни один не побеждает окончательно. Это то самое устойчивое состояние, которого я не мог собрать руками все предыдущие попытки. И все равно не бесконечное развитие. Конец света в этом отдельно взятом мирке происходит досадно часто =)
Где всё сейчас и что дальше
Сейчас работает то, что раньше было просто идеей в голове. В мире живут трава, олени, зайцы, мыши, лошади, волки, лисы, медведи и рыси, у каждого свой мозг, каждый решает сам за себя и передаёт свой мозг потомству с мутациями. Мир крутится сам, держит баланс и не разваливается, хищники охотятся, жертвы разбегаются заранее, стада не слипаются в кучу.
Дальше интересно копнуть в две стороны. В глубину это более сложное поведение: память, различия в характерах, стайная охота, что-то похожее на передачу опыта. Как раз здесь, скорее всего, и понадобятся дополнительные слои сети, без которых пока удавалось обходиться. В ширину это больше видов и стратегий и, возможно, несколько разных планет, у каждой со своим климатом и своей отдельной линией эволюции. Ну и хочется, чтобы за всем этим было приятно наблюдать, так что часть времени уходит на то, как мир выглядит.
Занятно, что задача решилась не тем способом, каким я долбил её в самом начале. Ну кто слышал про ИИ 10 лет назад? Пока я пытался прописать поведение и баланс руками, ничего устойчивого не выходило. Заработало только тогда, когда я перестал описывать поведение и начал его обучать, а баланс не выставлять вручную, а искать отбором. Ровно та самоорганизация из «Жизни» Конвея, ради которой я во всё это и полез, только теперь не на клетках, а на зверях с нейросетями. Есть даже название для таких затей — искусственная жизнь.
Ну и расцвет агентов, который позволял каждую идею, каждую правку делать масимально быстро. Иногда запуская по 5 сабагентов на речерч.
Мир крутится прямо сейчас — можно зайти и посмотреть: демо живого мира.
Честный дисклеймер: полной автономности и вечного баланса я пока не добился. Сам по себе мир всё ещё рано или поздно сваливается в вымирание. Поэтому в демо включён режим «Агентов Смитов» — они слегка вмешиваются, чтобы удержать мир от коллапса. Ждем Нео =)